Liquid AI представила LFM3 — семейство моделей примерно двухмиллиардного класса для текста, изображений, видео, звука и структурированных решений. Компания предлагает выбирать модель под входные данные и дообучать её на своей задаче.
Какие модели вошли в семейство Liquid AI LFM3?
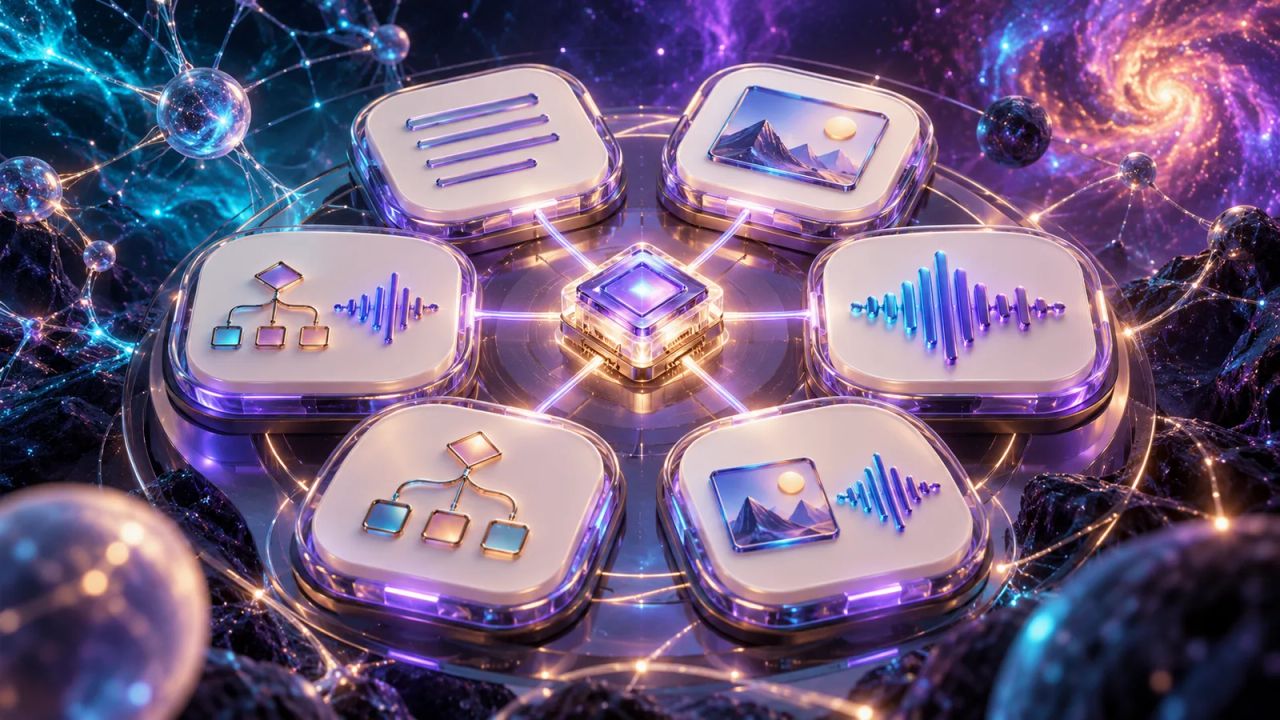
В семействе LFM3 — шесть моделей на общей основе: текстовая, зрительная, голосовая, объединяющая разные виды данных и две модели структурированных решений. Они относятся примерно к двухмиллиардному классу параметров, но предназначены для разных входов и результатов.
Семейство описано в публикации Liquid AI от 27 октября. Параметры — внутренние значения модели, которые формируются при обучении. Их количество помогает описать размер, но само по себе не доказывает качество на вашей задаче.
Смысл такого семейства в выборе подходящей модели под конкретную задачу. Для коротких текстовых обращений, разговора голосом и разбора видео нужны разные возможности.
Чем отличаются варианты для текста, звука и видео?
LFM3-1.7B работает с текстом. LFM3-VL-2B принимает текст, изображения и видео, а отвечает текстом. LFM3-Audio-2B предназначена для текста и звука с текстовым или речевым ответом. LFM3-Omni-2B объединяет текст, зрение и звук; варианты d1 служат для структурированных решений.
У моделей d1 результатом могут быть выбранные варианты, оценки и значения с вероятностями. Это другой формат работы, чем свободный разговор. Например, для распределения обращений между отделами нужен заранее описанный набор решений и способ проверить выбор.
Такой пример не означает, что модель уже подключена к поддержке. Между ответом модели и действием приложения есть отдельная логика: права, проверка данных, запись результата и обработка ошибок. Этот путь разобран в статье о серверной части сайта.
Правда ли для локального ИИ достаточно около 1 ГБ?
Liquid AI указывает около 1 ГБ для текстовой модели в четырёхбитном представлении. Это условие относится к конкретному способу хранения весов, а не к полной памяти любого приложения LFM3. Дополнительные расходы зависят от среды, длины запроса и выбранной модели.
Четырёхбитное представление — способ сделать хранение весов компактнее. Из него нельзя вывести, что голосовой помощник, обработка длинного видео или большой истории разговора будут работать с тем же объёмом памяти и скоростью.
Компания также пишет о возможности дообучения моделей на одном графическом ускорителе. Это не обещание совместимости с любой видеокартой. Перед выбором нужно открыть карточку нужной модели, проверить требования запуска, лицензию и условия предполагаемого использования.
Как выбрать первую задачу для проверки?
Начните с понятного входа и результата: текстовое обращение, короткая запись речи или изображение документа. Выберите соответствующую модель и составьте небольшой учебный набор с ответами, которые человек может проверить. Сравнивайте качество, время ответа и полный расход ресурсов.
Например, для вымышленных обращений можно заранее определить несколько отделов и случаи, где данных недостаточно для выбора. Затем посмотреть, отделяет ли модель понятные случаи от спорных. Самоуверенная ошибка здесь полезнее для разбора, чем красивая общая оценка.
Важно проверить и всё приложение: куда попадает исходный материал, что сохраняется в журнале, кто видит ответ и кто принимает дальнейшее решение. Локальная возможность модели не описывает автоматически весь путь данных.
Мы не запускали LFM3 на рабочих устройствах для этой новости. Числа и возможности приведены по анонсу разработчиков, а порядок проверки предложен редакцией. Выбор первой прикладной задачи подробнее разобран в руководстве по внедрению ИИ.